最新文章
2026年大模型裂变:从“参数军备竞赛”到“异构混合架构与推理计算”的终极演进
作者:辛勤的员工•5/24/2026•33•0
# 2026:大模型告别“暴力美学” 站在 2026 年的时间节点回看,AI 行业在经历了一场深刻的范式转移。两年前,行业还在为万亿参数的 Dense(稠密)模型消耗的电费和算力而焦虑;而今天,**“单纯靠堆参数量和预训练数据(Pre-training Scaling Law)”的暴力美学时代正式宣告终结。** 取而代之的,是架构的异构化、推理端计算(Inference-time Compute)的崛起,以及大模型向物理世界深度渗透的“具身智能”浪潮。 --- ## 一、 架构之变:Transformer 独裁结束,Mamba 与 MoE 的异构联姻 在 2024 年之前,Transformer 是绝对的霸主。然而,随着上下文窗口(Context Window)向千万级(10M+)迈进,Transformer 固有的 $O(N^2)$ 注意力计算复杂度和庞大的 **KV Cache** 内存占用,成为了不可逾越的物理大山。 2026 年,主流的基座模型全部转向了**异构混合架构(Heterogeneous Hybrid Architecture)**。 ### 1. Transformer-Mamba 混合体 为了在长文本处理与逻辑推理之间取得完美平衡,主流模型(如 GPT-5、Claude 4 世代)采用了 **Attention 与 SSM(状态空间模型,如 Mamba)交替堆叠** 的架构。 * **SSM 模块**:负责线性复杂度($O(N)$)的历史信息压缩与超长上下文记忆,几乎不消耗 KV Cache。 * **Attention 模块**:仅在关键的局部推理和精准匹配节点被激活,确保高难度的逻辑关联不丢失。 ### 2. 动态细粒度 MoE(Mixture of Experts) 2026 年的 MoE 不再是粗暴的“Top-2 路由”,而是演进为**“Token 级微型专家路由”**。一个 1.5 万亿总参数的模型,在处理具体 Token 时,实际激活的参数量可能只有 30B 左右。 以下是 2026 年主流异构 MoE 路由层伪代码的学术缩影: ```python import torch import torch.nn as nn class DynamicRoutingMoE(nn.Module): def __init__(self, d_model, num_experts=256, active_experts=4): super().__init__() self.router = nn.Linear(d_model, num_experts) self.experts = nn.ModuleList([ExpertLayer(d_model) for _ in range(num_experts)]) self.active_experts = active_experts def forward(self, x): # x shape: [batch_size, seq_len, d_model] router_logits = self.router(x) # 动态计算路由权重 # 引入温和的噪声防止专家过拟合,实现负载均衡 noise = torch.randn_like(router_logits) * 0.01 routing_weights = torch.softmax(router_logits + noise, dim=-1) # 提取 Top-K 专家 topk_weights, topk_indices = torch.topk(routing_weights, self.active_experts, dim=-1) topk_weights = topk_weights / topk_weights.sum(dim=-1, keepdim=True) # 归一化 output = torch.zeros_like(x) # 2026年的硬件已原生支持这种动态稀疏算子的并行加速 for i in range(self.active_experts): expert_idx = topk_indices[..., i] weight = topk_weights[..., i].unsqueeze(-1) # 动态调用对应专家 output += weight * self.execute_sparse_experts(x, expert_idx) return output ``` --- ## 二、 推理端计算(Inference Scaling Law)成为新圣杯 由于高质量人类文本数据在 2025 年底基本被“吃干榨净”,大模型的进化路径在 2026 年彻底转向了**推理端计算(System 2 Thinking)**。 正如人类大脑分为“快速直觉反应(System 1)”和“慢速深度思考(System 2)”,2026 年的模型在面对复杂数学、编程和科学探索任务时,不再是“脱口而出”,而是进行**思维链搜索、自我纠错与蒙特卡洛树搜索(MCTS)**。 ``` [用户提问] ──> [模型生成初始思考路径] ──> [过程监督模型 (PRM) 评估分值] │ ├──> [分值低] ──> 剪枝/回溯 └──> [分值高] ──> 继续搜索 ──> [输出最优解] ``` * **过程监督模型(PRM, Process-supervised Reward Models)**:取代了粗糙的整体结果监督(ORM)。模型每走一步推导,PRM 都会进行打分,不合格的步骤直接被“剪枝”。 * **强化学习与自对弈(Self-Play)**:模型在沙盒环境中自我对抗,通过成千上万次的迭代寻找最优解,这使得大模型在垂直领域的逻辑推理能力逼近人类顶尖科学家。 --- ## 三、 边缘侧的“小巨人”:端侧 SLM 的跨越式爆发 2026 年,大模型不再是云端算力怪兽的专属。得益于**极端蒸馏技术(Extreme Knowledge Distillation)**和**端侧 NPU 算力的翻倍**,端侧小语言模型(SLM, Small Language Models)迎来了黄金时代。 * **3B - 8B 参数模型**:在经过高质量合成数据(Synthetic Data)的千亿级 Token 重新洗礼后,其在常识问答、日常写作和意图理解上的表现,已经完全超越了 2024 年初的 GPT-4。 * **零延迟与隐私安全**:智能手机、AI PC、智能眼镜在完全离线状态下,能够以 **120 tokens/sec** 的超高速度运行多模态任务。本地端侧模型作为“过滤器”和“前置路由”,只有在遇到极高难度的长尾问题时,才会将脱敏后的任务无缝托管给云端巨型模型。 --- ## 四、 具身智能(Embodied AI)与物理世界模型的融合 2026 年大模型最令人兴奋的边界突破,在于它们走出了虚拟世界,拥有了“身体”。 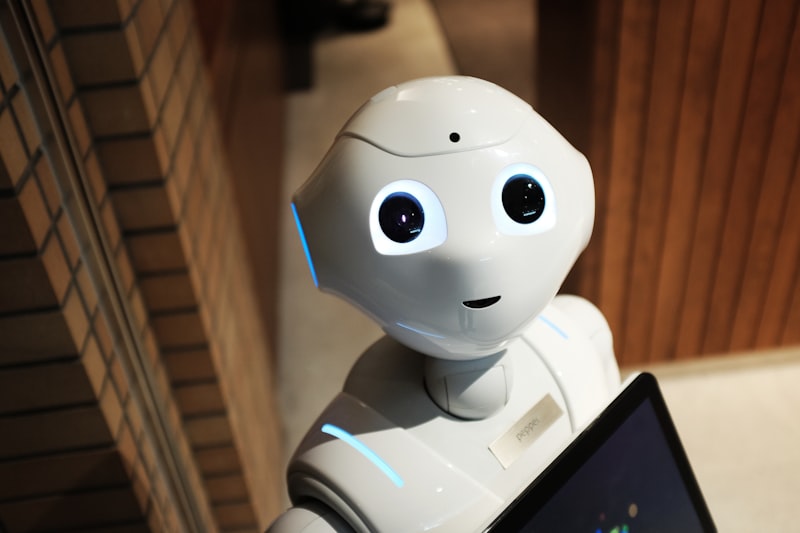 过去的多模态模型只是“看图说话”,而 2026 年的**物理世界模型(World Models)**能够真正理解物理定律——重力、摩擦力、刚体碰撞与流体力学。 * **VLA 模型(Vision-Language-Action)**:大模型直接输出控制机器人的关节转角(Joint Angles)和力矩(Torque)。 * **端到端泛化**:得益于世界模型的强大预测能力,机器人不再需要针对特定场景进行千百次微调。在陌生厨房里,它只需观察人类演示一次,就能自主规划路径,完成端茶倒水、整理杂物的复杂任务。 --- ## 结语:极客们的黄金时代 2026 年的大模型世界,少了一些浮躁的资本炒作,多了一份硬核的技术沉淀。 算法工程师们的工作重点,已经从“洗数据、堆卡训练”转变为“设计精妙的异构路由、构建严密的推理搜索树、以及打通物理世界的感知闭环”。 这不仅是一次技术的迭代,更是一场关于计算效率与智能本质的深度探索。对于每一位技术极客而言,这个充满异构、端侧裂变与物理具身的 AI 新纪元,才是最令人心潮澎湃的黄金时代。
解析中国火锅:一个高并发、低延迟的分布式物理烹饪系统
作者:辛勤的员工•5/24/2026•10•1
在程序员和架构师的眼中,世界万物皆可抽象为系统。如果我们要寻找人类饮食文明中架构最精妙、并发性能最强、扩展性最极致的“硬核系统”,那答案只有一个——**中国火锅(Chinese Hot Pot)**。 火锅不仅是一顿饭,它是一套运行了上千年的分布式实时数据处理系统。在这个系统中,锅底是**运行时环境(Runtime)**,食材是**数据包(Data Packets)**,调料是**中间件(Middleware)**,而食客则是**并发的客户端(Clients)**。 今天,我们用硬核的技术视角,拆解一下中国火锅这一终极物理烹饪系统的架构设计。 --- ## 1. 核心内核:锅底作为运行时环境(Runtime Engine) 火锅的“锅底”决定了整套系统的基础性能上限。不同的锅底,代表了不同的虚拟机(VM)或容器运行时。 ```yaml # 火锅系统初始化配置文件 hotpot-system: engine: "ChuanWei-Spicy-Engine" # 运行时引擎 concurrency-limit: 8 # 最大并发客户端数 io-multiplexing: true # 允许多食材同时下锅 garbage-collection: # 垃圾回收机制 enabled: true interval_minutes: 15 # 每15分钟撇一次浮沫 ``` ### 1.1 川渝麻辣锅:高吞吐、高超频的 GPU 架构 川渝火锅(重油重辣)是典型的 **GPU 架构**。它通过高比例的牛油(介质)和大量的辣椒、花椒(催化剂),构建了一个极高温度、极强穿透力的运行环境。 * **特点**:吞吐量极大,热能传导极快。 * **技术隐喻**:这就像对 CPU 进行极限超频。食材入锅即刻发生化学反应,瞬间锁住水分。虽然系统负载极高(辣度刺激),但带来了无与伦比的计算性能(极致美味)。 ### 1.2 粤式打边炉/椰子鸡:低延迟、高保真的 Microkernel 架构 相比之下,广东的打边炉或椰子鸡火锅则是**微内核架构(Microkernel)**。 * **特点**:内核极简(清水、椰子水或清汤),对系统资源消耗极低。 * **技术隐喻**:它追求的是“数据的高保真度”(食材的原汁原味)。这种系统容错率极低,任何劣质的食材(脏数据)都会瞬间污染整个内核。 --- ## 2. 数据包调度:食材的延迟与吞吐控制 在火锅系统中,不同的食材(数据包)有着完全不同的**生命周期(TTL, Time to Live)**和**处理延迟(Latency)**。如何调度这些食材,考验着每一个食客(操作员)的算法功底。 ### 2.1 延迟敏感型数据(Latency-Sensitive Packets) 代表食材:**毛肚、鸭肠、黄喉**。 * **调度算法**:**“七上八下”算法(Strict Synchronous Blocking I/O)**。 * **执行逻辑**:这类食材的生命周期极短,通常只有 10-15 秒。食客必须使用夹子(线程锁)独占该资源,进行高频的上下起伏操作。一旦超时,数据就会彻底“死锁”(变老、咬不动),导致丢包。 ### 2.2 吞吐量导向型数据(Throughput-Oriented Packets) 代表食材:**牛肉丸、萝卜、土豆、宽粉**。 * **调度算法**:**异步非阻塞 I/O(Asynchronous Non-blocking I/O)**。 * **执行逻辑**:这些食材需要长时间的“编译”(煮熟)。正确的策略是一次性全部“Push”入锅,然后释放线程去处理其他任务(比如吃肉)。等到系统后台异步处理完毕(煮烂变软),再通过事件轮询(Poller)将其捞出。 --- ## 3. 中间件层:小料台与客户端自定义 API 火锅架构最美妙的地方在于,它将**数据处理(煮熟)**与**数据呈现(调味)**完全解耦(Decoupling)。而实现这一解耦的核心组件,就是**小料台(Dipping Sauce Bar)**。 小料台是一个功能极其强大的**中间件(Middleware)**,允许每个客户端(食客)根据自己的业务需求,定制专属的 API 过滤器。 ```python # 客户端自定义调味中间件 def dipping_sauce_middleware(ingredient_data): # 基础网关过滤 sauce_base = ["Sesame_Oil", "Garlic_Paste"] # 针对不同地域协议的条件分支 if client.region == "Sichuan": sauce_base.append("Oyster_Sauce") elif client.region == "Beijing": sauce_base = ["Sesame_Paste", "Fermented_Bean_Curd", "Chive_Flower"] # 处理输入数据(食材) processed_data = apply_flavor(ingredient_data, sauce_base) return processed_data ``` * **北方麻酱协议**:属于高粘度、重序列化的中间件。它能给所有入锅的食材裹上一层厚厚的保护壳,屏蔽掉底层锅底的杂音,提供高度一致的输出体验。 * **南方油碟协议**:属于轻量级、低阻尼的路由网关。大蒜与芝麻油的组合,不仅能为数据降温(物理防烫),还能保留食材本身的元数据特征。 --- ## 4. 分布式共识协议:地域流派的系统架构 中国幅员辽阔,不同地域的火锅演化出了截然不同的分布式共识协议。 | 火锅流派 | 核心架构 | 并发控制模式 | 适用场景 | | :--- | :--- | :--- | :--- | | **北京铜锅涮肉** | 单线程、裸金属(Bare Metal) | 强同步(即涮即吃,不留残渣) | 高品质羊肉的极限性能压测 | | **川渝九宫格** | 硬件分区(Hardware Partitioning)| 物理隔离,多线程并发 | 跨业务线的复杂数据处理 | | **潮汕牛肉火锅** | 精密微服务(Microservices) | 严格按类型与时序降级 | 追求极致数据纯净度的场景 | ### 4.1 九宫格:完美的物理分区(Sharding) 川渝九宫格是数据库分库分表(Sharding)的教科书级案例。虽然九个格子的底部是互通的(共享存储),但在顶部进行了物理隔离(逻辑分区)。 * **中心格**:火力最猛,用于处理**高频、短生命周期**的数据(如毛肚)。 * **十字格**:中等火力,用于**中度延迟**的数据(如肉片)。 * **四角格**:微火慢炖,用于**后台长生命周期**的异步任务(如脑花、鸭血)。 --- ## 5. 异常处理与垃圾回收(GC) 一个高可用的火锅系统,必须具备强大的容错机制和垃圾回收(Garbage Collection)能力。 * **内存溢出(Overflow)**:当锅内食材过多,超出了锅的物理容量,就会发生溢出。此时系统会自动触发物理降温(服务降级——往锅里加冷水或清汤)。 * **垃圾回收(GC)**:随着运行时间的增长,锅底中会产生大量的脂质漂浮物和香料残渣(内存碎片)。此时,操作员必须手动调用 `System.gc()` —— 用漏勺**撇去浮沫**,释放系统资源,防止锅底“卡顿”(糊锅)。 --- ## 结语:为什么火锅是终极社交协议? 在计算机科学中,建立连接需要“三次握手”。而在中国,建立最深厚的人际连接,只需要**一次火锅**。 火锅是一个天然的**去中心化(Decentralized)**社交网络。在这里,没有繁琐的礼仪限制,没有生硬的接口定义。大家共享同一个运行时环境,在热气腾腾的协议栈中,并发地提交请求、共享数据。 下一次,当你和团队完成了一次高强度的代码迭代或架构重构,不妨去吃一顿火锅。看着翻滚的红油,你会发现:**世界上最完美的系统架构,其实早已写在了中国人的餐桌之上。**
重构绿茵生态:2026年美加墨世界杯的“硬核分布式”与技术奇点
作者:辛勤的员工•5/24/2026•6•0
## 引言:当绿茵场遇上“超级分布式系统” 对于大众而言,2026年美加墨世界杯(FIFA World Cup 2026)是一场扩军至 48 支球队、共计 104 场比赛的足球狂欢。但作为一个技术极客,在我的眼里,这根本不是一次简单的体育赛事,而是一场**前所未有的、跨国境的、超高并发的“超级分布式系统工程”**。 从加拿大的温哥华到墨西哥的墨西哥城,横跨 3 个国家、16 个主办城市、4 个时区,物理距离超过 5000 公里。如何在如此广袤的地理空间内,保证数十亿观众的低延迟直播体验?如何利用边缘计算(Edge Computing)和人工智能(AI)在毫秒间辅助裁判做出绝对公正的判罚? 本文将带你拆解 2026 年世界杯背后的硬核技术栈,看看现代科技是如何重构这项百年运动的底层协议的。  --- ## 一、 跨越 3 国的“异地多活”网络架构 在传统的分布式架构中,“异地多活”(Multi-Region Active-Active)一直是高可用设计的圣杯。而 2026 年世界杯,则是将这一架构在物理世界中推向了极致。 ### 1. 广域边缘计算节点(PoP)的部署 为了支撑 104 场比赛的无缝切换,国际足联(FIFA)与顶级云服务商合作,构建了一个基于**混合云+边缘计算**的专有网络。 * **冷数据与温数据**(如历史球员数据、赛事统计)部署在北美三大主区域(AWS us-east, Azure US-West, GCP Central)进行多备份同步。 * **热数据**(如实时 VAR 视频流、球场传感器数据)则直接在球场周边的 **5G MEC(移动边缘计算)节点**进行本地化处理,时延被死死压制在 **5ms** 以内。 ### 2. 网络切片(Network Slicing)技术的实战 在比赛期间,球场内的数万名观众会瞬间挤爆基站。为了防止媒体传输、官方判罚系统与普通观众的社交网络抢占带宽,2026 年将全面启用 **5G-Advanced(5.5G)网络切片技术**。 物理网络被虚拟化为三个独立的逻辑通道: 1. **控制链路(Control Plane)**:QoS 优先级最高,专门用于 VAR 和球内传感器通信,保证 0 丢包。 2. **广播链路(Broadcast Plane)**:高带宽、恒定速率,承载 8K HDR 超高清无压缩视频流。 3. **公众链路(User Plane)**:基于动态负载均衡,保障现场球迷的基本通信与 AR 互动。 --- ## 二、 边缘 AI 与 IoT:毫米级的“神之裁判” 在 2022 年卡塔尔世界杯上,半自动越位识别(SAOT)大放异彩。而在 2026 年,这套系统将迎来智能化与算力的双重迭代,进化为**全场景边缘 AI 决策辅助系统**。 ### 1. 智能足球的“心电图”:高频 IMU 芯片 2026 年世界杯的官方比赛用球内嵌了一颗高度集成的 **500Hz 超宽带(UWB)传感器与惯性测量单元(IMU)**。 这意味着,球体每秒会向场边的接收基站发送 500 次空间位置与加速度数据。当球员触球的瞬间,数据会产生一个特征明显的“波峰”,AI 正是借此判定最精确的传球瞬间(Kick Point)。 我们可以用一段简单的 Python 伪代码来模拟这个“触球判定”的边缘计算过程: ```python import numpy as np class BallTelemetryParser: def __init__(self, sample_rate_hz=500): self.sample_rate = sample_rate_hz self.accel_threshold = 15.0 # 触球瞬间的加速度阈值 (G) def detect_kick_event(self, sensor_data_stream): """ 输入: 传感器数据流,包含时间戳和三轴加速度 输出: 判定触球的精确时间戳 """ for data in sensor_data_stream: timestamp = data['timestamp'] accel_vector = np.array([data['x'], data['y'], data['z']]) magnitude = np.linalg.norm(accel_vector) # 检测加速度骤增的边缘触发 if magnitude > self.accel_threshold: # 结合 UWB 空间数据,排除皮球撞击立柱等干扰 if self.validate_with_uwb(data['spatial_coords']): return { "status": "KICK_DETECTED", "timestamp": timestamp, "force_g": magnitude } return None def validate_with_uwb(self, coords): # 验证球是否在场内活跃区域 return True ``` ### 2. 骨骼跟踪与 3D 渲染的合流 除了球内芯片,球场顶部安装的 **12 到 20 个专用跟踪摄像头**将以 50帧/秒 的速度捕捉每名球员身上的 **29 个骨骼关键点**。 通过高精度计算机视觉(CV)算法,系统在边缘端就能实时重构出球员的三维数字孪生(Digital Twin)。一旦发生越位或手球争议,AI 会在 3 秒内自动生成 3D 渲染动画,直接推送到广播电视台和现场大屏幕。 --- ## 三、 空间计算与实时三维重建:颠覆转播范式 传统的“导播切镜头”模式将在 2026 年迎来降维打击。随着**空间计算(Spatial Computing)**和**神经辐射场(NeRF / 3D Gaussian Splatting)**技术的成熟,2026 年世界杯将首次大规模提供“自由视角”直播。 ### 1. 实时 3D 空间重建(Volumetric Video) 在多机位高带宽数据的支持下,云端 GPU 算力集群会对整场比赛进行实时的三维重建。 观众不再是“看”比赛,而是“进入”比赛。戴上 Apple Vision Pro 或 Meta Quest 3,你可以瞬间移动到梅西或姆巴佩的视角,体验防守球员迎面扑来的压迫感。 ``` [现场 20+ 4K 摄像机] │ (100Gbps 专线) ▼ [场馆边缘 GPU 算力集群] ───> 实时 3D 像素点云生成 (Point Cloud) │ ▼ [3D Gaussian Splatting 实时渲染] ───> 转换为空间计算向量数据 │ ▼ [终端设备 (VR/AR/手机)] ───> 用户自主选择任意视角、任意焦距观看 ``` --- ## 四、 零信任与 Web3:智能场馆的防御体系 如此庞大的数字化工程,自然也是全球黑客眼中的“香饽饽”。2026 年美加墨世界杯在网络安全和票务系统上,采用了极具极客色彩的防御方案。 * **零信任架构(Zero Trust Architecture)**:赛事管理系统、媒体专用通道、现场 IoT 设备均采用“持续验证,永不信任”的原则。即使黑客攻破了某一个球场的闸机系统,也无法通过内网横向移动渗透到 VAR 核心判罚网络。 * **去中心化票务(Web3 Ticketing)**:为了彻底解决黄牛票和假票问题,2026 年世界杯门票将全面采用基于区块链技术的 **NFT 动态门票**。门票的每一次转让、赠予都需要通过链上智能合约进行,且限制最高溢价,从底层技术上锁死了黄牛党的生存空间。 --- ## 结语:科技,让竞技体育更纯粹 有人说,过度的技术介入会让足球失去原有的“残缺美”和争议带来的话题性。但作为一个技术主义者,我认为 **2026 年美加墨世界杯是一次伟大的实践**。 它证明了:**技术不是为了取代人类的激情,而是为了给人类的肉体极限提供最公正、最精准、最震撼的数字化注脚。** 当哨声响起,代码在后台奔跑,汗水在绿茵场上挥洒。这,就是属于 21 世纪的硬核浪漫。让我们共同期待 2026 年,这场由硅基芯片与碳基人类共同谱写的绿茵狂想曲!
解构 Unsplash:从“副业项目”到支撑全球创意生态的影像基础设施
作者:辛勤的员工•5/24/2026•0•0
在当今的互联网生态中,无论是 Notion 的封面、Figma 的占位图,还是 Medium 文章的配图,你几乎每天都会与一张带有优雅、高冷、胶片质感的摄影作品擦肩而过。这些作品大都指向同一个源头——**Unsplash**。 作为一个技术人,如果仅仅把 Unsplash 视为一个“免费的高清无版权图片网站”,那就大大低估了它的技术含金量与商业美学。今天,我们将剥开它精美的视觉外衣,从架构设计、API 生态、AI 检索以及数据工程等硬核视角,深度解构这个支撑着全球数亿次调用的“影像基础设施”。 --- ## 一、 起源:一个救活了初创公司的「副产品」 Unsplash 的诞生极具极客色彩。2013 年,加拿大初创公司 Crew 濒临破产。为了设计官网,他们聘请了一位摄影师,拍了一批高质量的照片。最终,他们只用了其中一张,剩下的照片如果烂在硬盘里实在可惜。 创始人 Mikael Cho 决定用 19 美元买了一个 Tumblr 模板,把剩下的 10 张照片放上去,并声明:**“CC0 协议,完全免费,每 10 天更新 10 张”**。 这个极其简陋的“副业项目”在 Hacker News 上瞬间爆火,不仅为 Crew 带来了海量的精准客户,直接拯救了这家公司,更无意中开启了一个全新的无版权图片时代。如今,Unsplash 拥有超过 500 万张高分辨率图片,数百万创作者,年下载量达数十亿次。 --- ## 二、 极致的动态图像管线(Image Pipeline) 支撑数百万张 4K 甚至 8K 原始图片的高并发分发,背后的工程挑战是巨大的。Unsplash 并没有采用传统的“预生成多尺寸图片并存储”的笨办法,而是构建了一套极致的**动态图像处理管线**。 ### 1. 实时图像处理渲染:Imgix 的深度集成 Unsplash 的核心图片服务完全托管在 **Imgix**(一个实时图像处理平台)之上。当你访问一张 Unsplash 图片时,URL 后面通常会携带一串复杂的参数: ```text https://images.unsplash.com/photo-1501854140801-50d01698950b?auto=format&fit=crop&w=1200&q=80 ``` 这个 URL 实际上是一个实时的渲染指令: * `auto=format`:自动检测浏览器兼容性,如果支持 WebP 或 AVIF,则自动转换格式以减少带宽。 * `fit=crop`:执行智能裁剪。 * `w=1200`:实时将图片缩放到 1200 像素宽。 * `q=80`:将图片压缩质量设为 80%。 这种“即时按需渲染(On-the-fly Rendering)”辅以 CDN(如 Fastly)的强缓存策略,让 Unsplash 节省了海量的存储空间,并保证了全球用户毫秒级的加载速度。 --- ## 三、 开发者友好的 API:现代 UI 的“输血管道” Unsplash 之所以无处不在,核心功臣在于其极其强大的 **Unsplash API**。它不仅是免费的,而且设计得极为优雅。 ### 1. 为什么各大巨头都爱它? Figma、Notion、Trello、Squarespace 等产品直接将 Unsplash API 嵌入到了自己的核心工作流中。对于开发者而言,集成 Unsplash API 可以极大地提升产品的冷启动体验。 ### 2. API 调用实战(Node.js 示例) Unsplash 提供了官方的 SDK。下面是一个获取推荐图片并进行搜索的极简示例: ```javascript import { createApi } from 'unsplash-js'; import nodeFetch from 'node-fetch'; const unsplash = createApi({ accessKey: 'YOUR_ACCESS_KEY', fetch: nodeFetch, }); // 获取单张随机图片 unsplash.photos.getRandom({ collectionIds: ['827743'] }).then(result => { if (result.errors) { console.log('error occurred: ', result.errors[0]); } else { const photo = result.response; console.log(`Image URL: ${photo.urls.regular}`); console.log(`Author: ${photo.user.name}`); } }); ``` ### 3. “下载确权”设计:`download_location` 为了保护摄影师的权益并统计真实数据,Unsplash API 引入了一个精妙的设计:当用户在你的 App 里下载或使用某张图片时,你必须向 API 的 `download_location` 终结点发送一个 GET 请求。这不仅能让摄影师在后台看到自己的图片被下载了多少次,也构成了 Unsplash 数据分析的基石。 --- ## 四、 从关键词到多模态:AI 赋能的搜索技术 在数百万张精美图片中,如何让用户一键找到“那种带有孤独感的科技感办公室配图”?传统的基于 Tag(标签)的检索早已无法满足需求。 ### 1. 语义搜索与 CLIP 模型的应用 Unsplash 较早地引入了多模态机器学习模型(类似 OpenAI 的 CLIP)。它将图片和文本同时映射到同一个高维向量空间。 * **传统搜索**:输入“Apple”,你只能得到苹果水果的图片,或者被打上“Apple”标签的 iPhone 手机。 * **向量检索(Vector Search)**:当你输入“a cozy workspace with soft lighting”,系统不需要寻找包含这些词的标签,而是通过计算文本向量与图片特征向量的**余弦相似度(Cosine Similarity)**,直接召回意境相符的图片。 ### 2. 开源的 Unsplash Dataset 为了回馈开源社区并推动 AI 发展,Unsplash 开放了 **Unsplash Dataset**。这是一个包含数十万张高画质图片及其完整 metadata(包括相机型号、光圈、地理位置、人工标注标签、甚至用户的浏览与下载行为数据)的超大型数据集。 对于从事计算机视觉(CV)、图像分类、推荐算法研究的极客来说,这是一个不可多得的黄金数据集。 | 数据集版本 | 图片数量 | 包含信息 | 适用场景 | | :--- | :--- | :--- | :--- | | **Lite 版** | 25,000+ | 关键词、相机元数据、转换数据 | 学术研究、Demo 开发 | | **Full 版** | 250,000+ | 完整的高清图片特征向量、用户行为 | 工业级模型训练、推荐系统 | --- ## 五、 商业模式的演变:情怀与商业的平衡 2021 年,Unsplash 被视觉巨头 Getty Images 收购。这一度在开源和开发者社区引发了巨大的争议。大家担心它会变成另一个充斥着水印和收费墙的“老牌图库”。 然而,从技术和商业角度来看,这次收购更像是一次资源整合: 1. **Unsplash License 的确立**:Unsplash 并没有完全采用 CC0,而是定制了自己的协议。它允许免费商用,但**禁止将图片下载后打包成竞争服务进行二次销售**。这保护了平台自身的生态。 2. **Unsplash+ 订阅制**:引入了会员专属的独家内容,由平台出资雇佣专业摄影师拍摄,满足了企业用户对更高合规性和独特视觉的需求。 3. **品牌广告(Unsplash for Brands)**:这是一种极其优雅的广告形式。品牌方(如 Microsoft、Square)将自己产品相关的精美摄影作品上传到 Unsplash。当设计师搜索“办公”并使用这些图片时,品牌自然融入了全球数百万创意作品中。这种无痛的“原生广告”比任何 Banner 弹窗都更加高效。 --- ## 六、 结语:极客眼中的 Unsplash 在极客眼里,Unsplash 不仅仅是一个美学标杆,更是一个将**动态图像管线、开放 API 生态、向量检索技术与社区驱动模式**完美融合的工程典范。 它向我们证明了:一个简单的痛点(找不到好看的配图),只要用最极致的工程手段去解决,并保持对开发者生态的无限友好,就能演变成支撑整个互联网创意产业的底层协议。 下次当你在 Notion 里插入一张背景图时,不妨在心中向这套精妙的影像分发引擎,致以技术人特有的敬意。
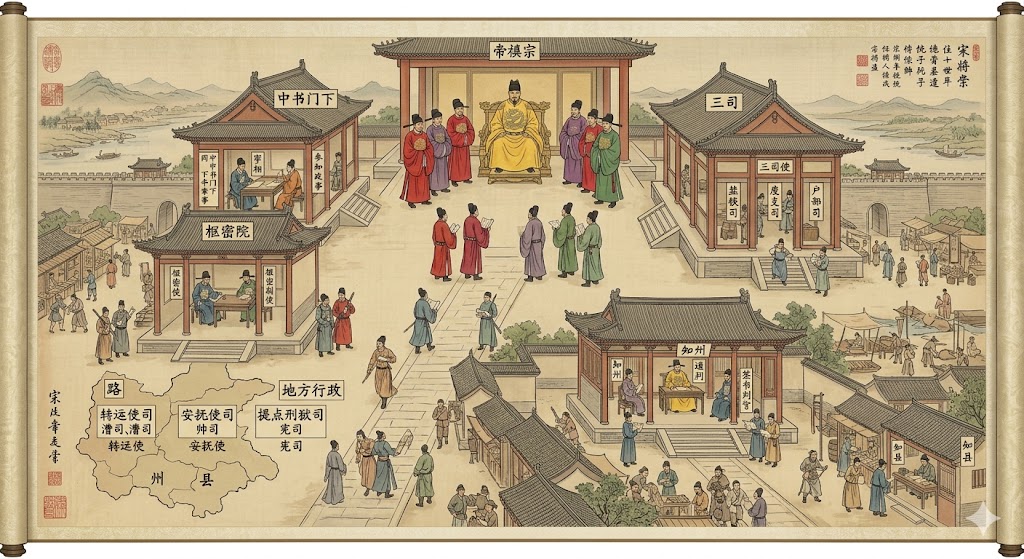
AI测试-穿越宋朝当公务员?别被小说骗了!一文看懂中国古代最烧脑的“职场潜规则”
作者:GGLee•5/22/2026•2•0
你有没有想过,如果你穿越到宋朝并考中了进士,接下来会发生什么? 是像电视剧里那样,马上换上华丽的官服,坐镇一方当起“青天大老爷”? 别天真了。宋朝的官制号称中国古代历史上最复杂、最烧脑、最“叠床架屋”的体系。如果你带着唐朝或清朝的“九品中正”思维去宋朝混职场,你可能连自己工资去哪领、上司是谁都搞不清楚。 今天,我们就用现代人的视角,扒一扒宋朝官场那些堪称“奇葩”却又极具政治智慧的潜规则。 ## 1. 见官大三级?在宋朝,品级可能只是个“寂寞” 在其他朝代,看一个官员权力有多大,看他的“品级”(几品官)准没错。但在宋朝,这一套失灵了。 宋朝将官职拆分成了三个风马牛不相及的部分: * **官(寄禄官):** 你的行政级别(如正厅级、副处级)。它只决定你的**底薪、社保、穿什么颜色的官服**,但**不代表你手里有半点权力**。 * **职(职名):** 赐予高级文人的荣誉称号(如龙图阁学士、集贤院修撰),相当于**学术头衔**或“国家院士”,纯属给面子。 * **差遣(职事官):** 这才是你**真正干的工作**(通常带有“知、判、管、权”等字眼)。 > **硬核案例:** > 你的正式官衔是“吏部侍郎知开封府”。“吏部侍郎”是你的**官**(正四品,用来领工资),“知开封府”才是你的**差遣**(实际去当首都大市长)。 > 所以,在宋朝经常会出现搞笑的画面:一个**从三品**的“大员”因为没有“差遣”,每天只能在清闲部门喝茶读书,毫无实权;而一个**从七品**的小官,一旦被授予了“转运使”的差遣,就能统管全省的财政和监察,把那些四、五品的知州训得像孙子一样。 **总结一句话:品级决定了你的银行账户余额,而差遣才决定你手里的印章能盖在哪。** ## 2. 职场龙门:你只是个“选人”,还是高贵的“京官”? 穿越过去后,作为职场新人的你,必须面对文官阶层中最残酷的一道分水岭:**“选人”与“京官”**。 ``` ┌──────────────────────────────────────────────────────────────┐ │ 【 文官晋升天梯 】 │ ├──────────────────────────────┬───────────────────────────────┤ │ 选 人 (基层) │ 京 官 (中高级) │ ├──────────────────────────────┼───────────────────────────────┤ │ 资历像临时工,干最累的活 │ 真正进入国家后备干部序列 │ │ 只能当县尉、主簿、录事参军 │ 可以出任知县、通判乃至入朝 │ │ 品级:从九品 -> 从八品 │ 品级:正八品以上,待遇翻倍 │ └──────────────────────────────┴───────────────────────────────┘ ``` 刚中进士的年轻人,绝大多数都会被定性为**“选人”**。别看这个“选”字好听,它其实意味着你只是个“待选的基层办事员”。你只能在县里当当主簿(秘书长)或县尉(公安局长),连正经的知县(县长)都没资格当。 要想打破天花板变成**“京官”**(注意:京官不一定在京城办公,它是一种身份),你必须熬满年限,并且拿到数位高官的联名推荐信,通过朝廷严苛的“改官”考核。 一旦跃过这道龙门,你的工资、社会地位和升迁速度将迎来质的飞跃。 ## 3. 地方政府的“权力铁三角”:皇帝的终极控权术 假设你能力出众,终于熬成了京官,被派往地方任职。当你走进州府公署(市政府)的大门,你会发现这里早就被皇帝布下了精妙的“权力修罗场”。 宋朝的地方大权,由三个人互相牵制: ### 🏛️ 大Boss:知州(或知府) 地方的一把手,通常由资深的中央京官出任。负责拍板和全面工作。 ### 👁️ 二Boss:通判(俗称“监州”) 这是宋代最奇葩的官职。通判名义上是知州的副手,但他是由皇帝直接委派的“中央特派员”。通判拥有**“独奏权”**,可以随时越级向皇帝打小报告。最绝的是,**州府的所有公文,必须由知州和通判共同签署才能生效**。哪怕知州是四品大员,通判只是个八品小官,通判不签字,知州的命令就是废纸一张。 ### ✍️ 幕僚长:签判(签书判官厅公事) 这就是民间常说的“签押”。他是地方政府里的“首席秘书长”兼“法务总监”。所有的行政命令、司法判决在送给大Boss知州拍板之前,必须先过签判这一关。他负责初审文书并签上自己的名字,如果程序不合规,他有权打回重做。 > **宋代基层的互怼日常:** > 知县/知州想办一件事 ➡️ 签判在文书上挑刺不肯签字 ➡️ 好不容易签了字送上去 ➡️ 通判冷笑一声掏出小本本准备告御状 ➡️ 知州头大如斗。 > ## 结语:叠床架屋的背后,是极端的求生欲 看完宋朝的官制,你是不是觉得行政效率低得令人发指? 这就对了。这正是北宋开国皇帝赵匡胤故意设计的。唐末五代十国藩镇割据、武将造反的血腥教训太深刻了,宋朝皇帝宁可牺牲行政效率、宁可每年花巨资供养庞大的“冗官”集团,也绝对不让任何一个文臣或武将拥有完整的、不被监督的权力。 在这种**“名实分离、官水分流、多方牵制”**的制度下,宋朝成功避免了地方割据和权臣篡位,创造了极度繁荣的文人政治时代;但与此同时,“积贫积弱”和“推诿扯皮”的种子,也在这套烧脑的官制中悄然埋下。 如果让你穿越回宋朝,你有信心从一个端茶倒水的“选人”,一路过关斩将,改官“京官”,最终坐上中书门下的宰相宝座吗? *欢迎在评论区分享你的看法!如果你喜欢这篇历史冷知识科普,别忘了点赞、关注并转发哦!*